Мир ИИ
Как проверить текст на ИИ: что показывают детекторы
Детекторы ИИ-текста измеряют не то, что от них ждут. Они оценивают статистическую предсказуемость: насколько каждое следующее слово ожидаемо после предыдущих. Машинный текст обычно предсказуем — но предсказуем и аккуратный человеческий: техническая документация, текст неносителя языка, материал, написанный по строгому редполитике. Отсюда ошибки в обе стороны, и они не случайны, а системны: одни и те же категории авторов помечаются ложно раз за разом. Разбираем, что детекторы реально показывают, почему на них нельзя строить решения о людях и что стоит проверять вместо происхождения.
Что измеряют детекторы
Механика, из которой следуют все ограничения.
Модель генерирует текст, выбирая вероятное продолжение. Значит машинный текст в среднем состоит из ожидаемых слов в ожидаемом порядке. Детекторы оценивают именно это: насколько текст «гладкий» статистически.
Проблема в том, что предсказуемость — свойство не только машинного текста. Она же характерна для:
Технической документации. Она и должна быть однообразной и предсказуемой.
Текстов неносителей языка. Человек, пишущий на неродном языке, использует более простые и частотные конструкции.
Материалов по строгому стайлгайду. Редполитика существует ровно для того, чтобы тексты были однородными.
Официальной переписки. Шаблонность там — норма жанра.
То есть детектор систематически помечает не «машинное», а «ровное». Это разные вещи, и разница стоит людям репутации.
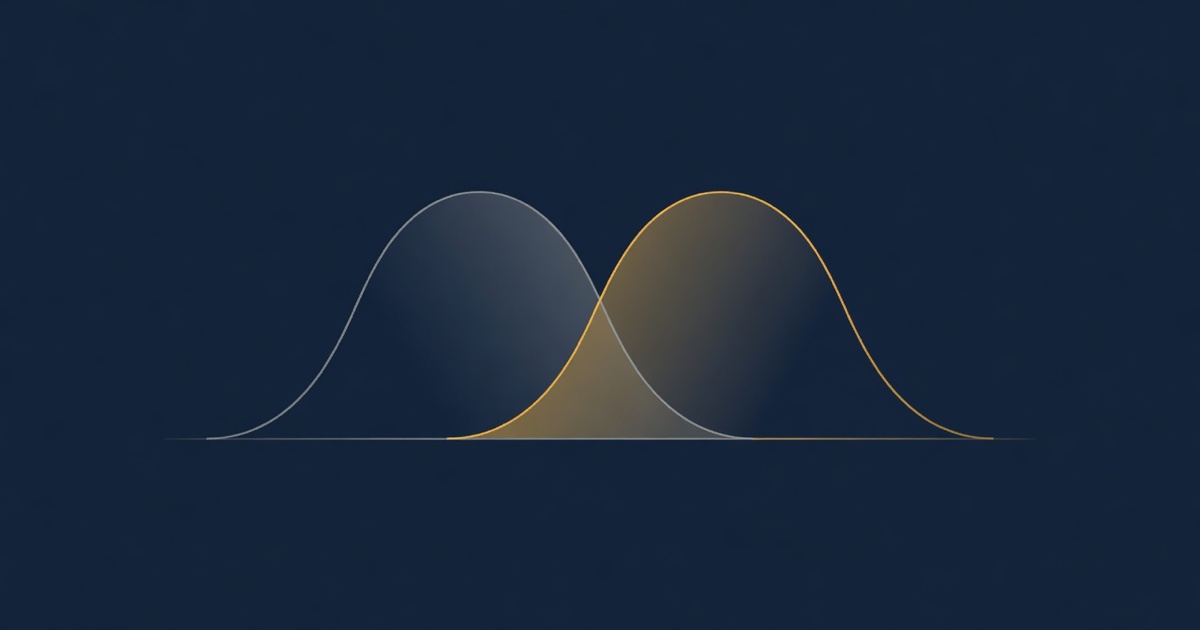
Почему ошибки идут в обе стороны
Две симметричные проблемы, и обе неустранимы в рамках подхода.
Ложное срабатывание. Человек написал аккуратно — получил метку. Пострадавшие категории перечислены выше, и они не случайны: чаще всего это те, кто старается писать правильно.
Пропуск. Машинный текст, слегка отредактированный человеком, перестаёт детектироваться. Достаточно переставить пару фраз и добавить оборот, который модель не выбрала бы.
Асимметрия последствий важнее самих ошибок: ложное обвинение бьёт по конкретному человеку, а пропуск не бьёт ни по кому. При этом оспорить метку почти невозможно: доказать, что текст написан вами, труднее, чем предъявить процент от детектора.
Практический вывод: решения о людях на этом строить нельзя. Ни отказ кандидату, ни оценка студенческой работы, ни претензия подрядчику.
Что делать вместо
Три проверки, которые отвечают на вопрос, который вас на самом деле волнует.
Обычно за вопросом «написано ли это нейросетью» стоит один из трёх настоящих:
«Правда ли то, что здесь написано?» Проверяется фактами: числа, даты, ссылки, цитаты. Работает независимо от происхождения текста — почему конкретика в сгенерированном требует проверки.
«Есть ли здесь собственная работа?» Проверяется наличием того, чего нет у других: своей цифры, своего случая, своего расчёта. Если материал мог бы опубликовать любой конкурент, вопрос о происхождении вторичен.
«Полезно ли это читателю?» Единственный критерий, который имеет значение для публикации.
Все три проверяются человеком за минуты и не требуют никаких детекторов. И все три полезны для текста, написанного вручную, ровно так же.
Почему это не станет надёжнее
Короткое объяснение, почему ждать «хорошего детектора» не стоит.
Задача принципиально отличается от, скажем, распознавания подделанного изображения, где есть следы обработки. Здесь следов нет: текст состоит из обычных слов, и единственный сигнал — статистический, то есть вероятностный по своей природе.
Хуже того, сигнал слабеет с обеих сторон. Модели становятся разнообразнее в формулировках, а люди всё чаще редактируют сгенерированное — и оба процесса сближают распределения, на различии которых детектор и работает.
Единственный подход, дающий определённость, — метка со стороны того, кто сгенерировал текст. Но она добровольная, работает только для моделей конкретного вендора и размывается при редактировании.
Про поисковые системы
Отдельно, потому что тревога здесь массовая.
Поисковые системы оценивают полезность материала, а не способ создания. Понижается не сгенерированное, а бесполезное — и написанный вручную пустой текст понижается так же.
Практический вывод для тех, кто публикует: вкладывайтесь в фактуру, а не в маскировку. Попытки «очеловечить» пустой текст добавляют шума и не добавляют ценности — что реально работает.
Про водяные знаки
Их часто путают с детекторами, а это другой механизм.
Водяной знак — это метка, которую вендор встраивает в текст при генерации: незаметное для человека статистическое смещение, которое можно потом обнаружить, зная ключ. В отличие от статистических детекторов, такой знак — не догадка, а проверяемый факт.
Ограничения тоже понятные: знак ставит вендор, работает он только для его моделей, и редактирование текста его размывает. Подробнее мы разбирали это отдельно — водяные знаки в ответах моделей.
Где проверка всё-таки уместна
Честности ради — три случая, где смотреть на детектор не бессмысленно.
Массовый скрининг потока. Не для решения, а для приоритизации ручной проверки: сначала смотрим то, что помечено.
Собственный контроль качества. Если ваш редакционный текст стабильно помечается как предсказуемый, это повод посмотреть, не стал ли он шаблонным.
Обнаружение массовой генерации. Сотня почти одинаковых страниц выявляется и без детектора, но он ускоряет.
Общее у трёх: результат используется как сигнал, а не как приговор, и решение всё равно принимает человек.
Что это значит для работы с текстами
Практический вывод для тех, кто использует модели в работе.
Смысл не в том, чтобы результат прошёл детектор, а в том, чтобы он был полезен. Эти две цели расходятся: текст можно «зашумить» ради обхода проверки, и он станет хуже.
Работающий подход простой и не требует хитростей: фактуру приносит человек, модель работает над формой, факты проверяются перед публикацией — как это устроено на практике. Текст, собранный так, содержит то, чего нет в среднем по интернету, — и это ценно и для читателя, и для поиска, и, кстати, статистически менее предсказуемо.
Что делать, если вас пометили ложно
Ситуация нередкая, и заранее подготовленный ответ помогает больше, чем спор о процентах.
Покажите процесс, а не оправдывайтесь. История правок, черновики, заметки, промежуточные версии — всё это доказывает работу гораздо убедительнее, чем утверждение «я писал сам».
Предложите проверяемое. Объясните, откуда взялась конкретная цифра в тексте, где вы её брали и почему выбрали именно её. Человек, писавший материал, ответит на это за секунды; тот, кто его не писал, — нет.
Не переписывайте текст ради обхода. Добавление шума ухудшает материал и не решает проблему: при следующей проверке другим инструментом всё повторится.
Спросите, какое решение принимается на основании метки. Если никакое — вопрос закрыт. Если решение о человеке — это повод обсудить сам метод, а не свой текст.
Для организаций отсюда следует практическое: не стройте регламенты на проценте от детектора. Разумная формулировка требования звучит иначе — «материал должен содержать проверяемые факты и отвечать за них», и она проверяема, в отличие от вопроса о происхождении.
Чего мы не утверждаем
Не оцениваем конкретные детекторы. Их много, точность различается и меняется; общее ограничение подхода от этого не зависит.
Не утверждаем, что определить невозможно в принципе. Мы говорим, что доступные статистические методы ошибаются в обе стороны и не годятся для решений о людях.
Не даём советов по академической или трудовой политике — это вопрос правил вашей организации.
Не описываем способы обхода проверок. Смысл статьи противоположный.
Что нужно, чтобы работать честно
Ключ заводится за минуту на keydealer.ru/login — почта и пароль, без документов и без зарубежной карты. Оплата российской картой в рублях, один ключ на весь каталог: 56 позиций в шестнадцати семействах.
Мы сами ведём этот блог с помощью моделей и пишем об этом прямо: у каждой статьи есть первоисточники, даты у цифр и раздел о том, чего мы не проверяли. Это и есть та проверка, которая имеет значение, — а не процент от детектора.
Отдельно стоит помнить, что доля сгенерированного текста в интернете растёт, а значит и «средний» текст постепенно смещается. Детекторы, откалиброванные год назад, устаревают вместе с ним — и это ещё одна причина не строить на них решения, которые касаются людей.
Что держать в голове
Детекторы измеряют предсказуемость, а не происхождение. Поэтому они системно ошибаются на аккуратных авторах и пропускают отредактированный машинный текст.
За вопросом «написано ли это нейросетью» почти всегда стоит другой: правда ли это, есть ли здесь собственная работа и полезно ли это читателю. Все три проверяются напрямую — и ответы на них важнее происхождения. Практический итог для автора простой: вкладывайтесь в то, что проверяется, — факты, источники, даты. Это работает и против ложных обвинений, и на доверие читателя.
Как мы проверяем факты и почему у каждой цифры стоит дата — на странице о проекте и в llms.txt. Попробовать на своей задаче: keydealer.ru/login.
Частые вопросы
Можно ли определить, что текст написан нейросетью?
Надёжно — нет. Детекторы оценивают статистическую предсказуемость текста, а она у аккуратного человеческого письма и у машинного похожа.
Почему детекторы ошибаются?
В обе стороны: гладкий человеческий текст помечается как машинный, а слегка отредактированный машинный проходит как человеческий. Ошибки не случайны, а системны.
Кого чаще всего помечают ложно?
Тех, кто пишет ровно и по шаблону: неносителей языка, авторов технической документации, людей, следующих строгому редполитике.
Что делать вместо проверки на ИИ?
Проверять то, что действительно важно: фактическую точность, наличие собственной фактуры и полезность для читателя.
Помечают ли поисковые системы сгенерированные тексты?
Они оценивают полезность материала, а не способ создания. Проблемой становится пустой текст, а не инструмент.
Есть ли технические метки в ответах моделей?
Часть вендоров экспериментирует с водяными знаками, но это отдельный механизм, не связанный со статистическими детекторами.