LLM API и интеграция
Что такое инференс простыми словами
Инференс — это работа уже обученной модели на вашем запросе. Слово звучит техническим, а стоит за ним простая вещь: обучение создало модель один раз, а инференс происходит каждый раз, когда вы к ней обращаетесь, — и именно за него вы платите. Понимание того, из чего он складывается, объясняет вещи, которые иначе выглядят произволом: почему выход дороже входа, почему длинный контекст замедляет первый ответ, почему у некоторых вендоров цена зависит от часа суток и почему дешевле уже не становится. Разбираем без математики.
Инференс против обучения
Различие, из которого следует вся экономика.
Обучение — процесс создания модели. Происходит один раз, требует огромных мощностей и месяцев, стоит вендору столько, что цифры называют в миллиардах. К вашему счёту отношения не имеет.
Инференс — использование готовой модели. Происходит на каждый запрос, требует мощностей на секунды и стоит копейки за раз. Это и есть то, за что вы платите.
Отсюда сразу понятно, почему дообучение под свою задачу — отдельная и дорогая история: оно ближе к первому процессу, чем ко второму.
Из чего складывается один запрос
Две фазы, и они устроены по-разному.
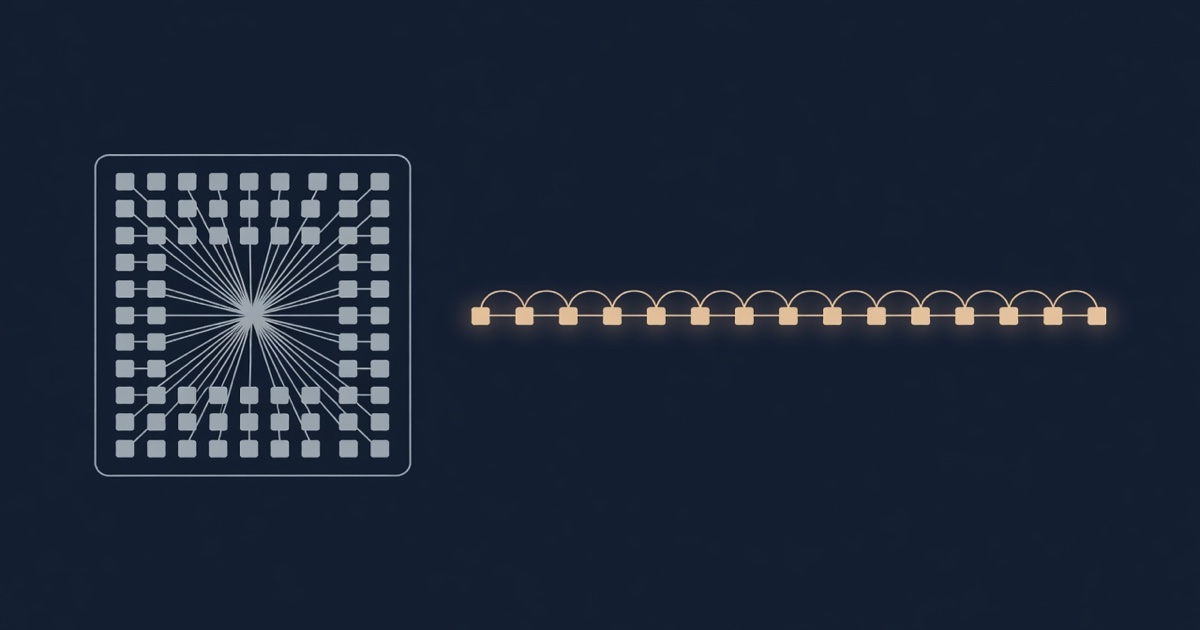
Обработка входа. Весь ваш промпт уходит в модель разом, токены считаются параллельно. Это быстро в пересчёте на токен и относительно дёшево.
Генерация выхода. Модель выдаёт по одному токену за раз, и каждый следующий требует нового прохода по всей сети с учётом всего, что уже написано. Тысяча выходных токенов — это тысяча проходов, а не один.
Отсюда два следствия, которые видно в любом прайсе:
Выход дороже входа. У официальных API обычно в пять-шесть раз. Это не наценка, а разная вычислительная нагрузка — подробный разбор.
Длинный запрос задерживает первый токен. Фаза обработки растёт с объёмом, и пользователь видит это как «долго думает» — из чего складывается задержка.
Почему это стоит денег
Три статьи, которые вендор оплачивает независимо от вас.
Видеопамять. Модель должна целиком поместиться в память ускорителя. Грубый ориентир — около гигабайта на миллиард параметров при обычном сжатии весов, плюс запас под контекст. Модель на сотни миллиардов параметров требует стойки, а не карты.
Вычисления на каждый токен. Они происходят при каждом обращении и не кэшируются сами по себе.
Простой. Железо покупается под пиковую нагрузку. Ночью оно стоит без дела, но амортизируется всё равно.
Третья статья и объясняет то, что выглядит странно: тариф, зависящий от часа суток. Вендор пытается выровнять кривую нагрузки экономически, а не техникой — почему это появилось уже у трёх вендоров.
Что удешевляет инференс
Четыре механизма, которые встречаются в прайсах.
Кэш повторного контекста. Если начало запроса не изменилось, результат его обработки переиспользуется. Скидка бывает кратной — как это устроено и где работает.
Отложенная очередь. Задача выполняется, когда есть свободные мощности; ставка ниже вдвое.
Модель поменьше. Меньше параметров — меньше вычислений на токен, отсюда и разброс цен внутри одной линейки.
Более короткий ответ. Единственный рычаг, который целиком в ваших руках.
Последний пункт стоит выделить: ограничение длины ответа снижает и счёт, и задержку одновременно, и это самое дешёвое улучшение из существующих.
Где происходит инференс
Три варианта, и у каждого своя экономика.
У вендора модели. Вы обращаетесь напрямую к тому, кто её обучил.
У посредника. Между вами и вендором стоит сервис, решающий вопросы оплаты и доступа. Мы — как раз этот случай, и это стоит называть прямо: дополнительное звено со своими рисками доступности.
У вас. Только для моделей с открытыми весами. Закрытые локально не запускаются ни при каких условиях, а расходы на своё железо считаются иначе — когда это оправдано.
Почему цены не падают бесконечно
Наблюдение, объясняющее происходящее на рынке.
Открытые веса давят прайсы вниз: если модель можно скачать, платить за неё много никто не станет. Но у инференса есть себестоимость — железо, электричество, время, — и ниже неё цена не опускается.
Когда прайс упирается в этот пол, вендоры начинают не снижать цену, а перераспределять нагрузку: появляются пороги по длине контекста, режимы обработки, почасовые окна. Все три множителя мы разбирали отдельно — Batch, Flex и Fast.
Практический вывод для планирования: ставка за миллион токенов перестала быть единственным числом, определяющим счёт. Сравнивать провайдеров нужно расчётом под свой профиль — как это делать.
Что из этого следует для вас
Пять практических выводов.
Сокращайте выход, а не вход. Он дороже и он же управляем.
Не отправляйте лишнего. Длинный контекст стоит денег и задерживает первый ответ.
Считайте объём в токенах. Не в символах: кириллица расходует больше латиницы — как считать.
Берите модель по задаче. Разница между позициями внутри одной линейки бывает двадцатикратной, а на типовых задачах результат сопоставим.
Проверяйте на дешёвых. В каталоге на 9 сентября 2026 года 49 позиций в пятнадцати семействах, шесть текстовых тарифицируются по нулевой ставке — что там доступно.
Откуда берутся разные цены на одну модель
Практическое следствие, которое видно на рынке и объясняется устройством инференса.
Одна и та же модель у разных площадок стоит по-разному, и это не всегда наценка посредника. Влияют:
Конфигурация железа. На разных ускорителях один и тот же инференс обходится по-разному.
Загрузка. Площадка с ровной нагрузкой окупает железо лучше, чем та, у которой пики и провалы.
Что включено в ставку. Где-то отдельно тарифицируется кэш, где-то пороги по длине, где-то приоритет обработки.
Наценка за доступ. У посредников — за оплату, маршрутизацию и поддержку. Мы в их числе, и это стоит называть прямо.
Отсюда практический вывод для сравнения: цифра в прайсе сравнима только вместе с условиями. Одинаковая ставка за миллион у двух площадок может означать разный счёт при одинаковой нагрузке — и наоборот, разные ставки могут сойтись в одну сумму на вашем профиле.
Проверяется это расчётом на своих числах за полчаса — как выбрать провайдера.
Зачем это знать заказчику, а не только инженеру
Короткое соображение для тех, кто согласует бюджет.
Понимание инференса отвечает на три вопроса, которые обычно задают при планировании.
Почему нельзя назвать цену за «один запрос». Она зависит от длины входа и выхода, а те — от задачи. Считать надо профиль, а не единицу.
Почему длинный документ дороже короткого вопроса в разы. Потому что весь он проходит через фазу обработки, и оплачивается целиком при каждом обращении.
Почему экономия ищется в длине ответа. Это единственный множитель, который вы контролируете, и он бьёт по самой дорогой стороне счёта.
Эти три ответа снимают большую часть споров о бюджете — и заодно объясняют, почему прикидка «сколько стоит миллион токенов» без описания сценария бессмысленна.
Чего мы не утверждаем
Мы упрощаем. Внутреннее устройство инференса сложнее описанного; здесь дана рабочая модель понимания.
Не приводим ориентиров по железу как точных. Требования зависят от модели, сжатия весов и настроек.
Не сравниваем провайдеров по себестоимости. Она не публикуется.
Цифры каталога — на дату. Состояние на 9 сентября 2026 года.
Что нужно, чтобы попробовать
Ключ заводится за минуту на keydealer.ru/login — почта и пароль, без документов и без зарубежной карты. Оплата российской картой в рублях, один ключ на весь каталог.
Ставки, статусы протоколов и условия доступа видны в GET /v1/models без ключа и без регистрации. Платные текстовые модели доступны сразу на приветственном бонусе — посчитать свой первый запрос в токенах и рублях можно за пять минут.
И про перспективу: понимание инференса объясняет, почему цены перестали снижаться линейно. Пока была гонка за долю рынка, вендоры продавали ниже себестоимости; сейчас прайсы упёрлись в железо, и дальнейшая экономия достигается не снижением ставки, а перераспределением нагрузки — окнами, режимами и кэшем.
Что держать в голове
Инференс — это каждое использование модели, и платите вы именно за него. Обучение к вашему счёту отношения не имеет.
Выход дороже входа не по прихоти прайса, а потому что генерируется по одному токену за раз. Отсюда и главный рычаг экономии, который целиком в ваших руках: длина ответа. Проверить теорию проще всего на своём запросе: посмотрите в ответе число входных и выходных токенов и умножьте на ставку — расхождение с ожиданием обычно и объясняется тем, что описано выше.
Как мы проверяем факты и что храним из запросов — на странице о проекте и в llms.txt. Посчитать свой запрос: keydealer.ru/login.
Частые вопросы
Что такое инференс?
Работа уже обученной модели на вашем запросе: она получает текст и выдаёт ответ. Обучение — это отдельный, разовый и несопоставимо более дорогой процесс.
Чем инференс отличается от обучения?
Обучение создаёт модель и происходит один раз. Инференс — это каждое её использование. Вы платите именно за инференс.
Почему инференс стоит денег?
Он требует видеопамяти и вычислений на каждый токен. Железо покупается под пик нагрузки и оплачивается независимо от того, идут запросы или нет.
Почему выход дороже входа?
Вход обрабатывается за один проход, а выход генерируется по одному токену, и каждый требует нового прохода по модели.
Что такое время до первого токена?
Задержка между отправкой запроса и появлением первого символа ответа. Она растёт с длиной вашего запроса.
Можно ли делать инференс у себя?
Только для моделей с открытыми весами. Закрытые модели локально не запускаются ни при каких условиях.