LLM API и интеграция
Эмбеддинги и rerank: что нужно для поиска
Разговор про поиск по своим документам почти всегда начинается с эмбеддингов, а стоило бы — с разбиения текста. Эмбеддинги превращают смысл фрагмента в набор чисел, чтобы похожее находилось по смыслу, а не по совпадению слов. Полезно, но это второй по важности слой: если содержимое нарезано плохо, векторный поиск найдёт бессмысленные куски так же аккуратно, как обычный. А сверху есть третий слой — переранжирование, который часто даёт больше, чем переход на векторы. Разбираем, что за что отвечает, где можно обойтись без сложного и чего у нас нет.
Что такое эмбеддинги
Объяснение без математики.
Модель превращает фрагмент текста в длинный набор чисел. Устроено это так, что близкие по смыслу тексты получают близкие наборы: «как вернуть товар» и «оформление возврата покупки» окажутся рядом, хотя общих слов у них почти нет.
Поиск после этого сводится к геометрии: берём вектор запроса, ищем ближайшие векторы фрагментов, возвращаем их.
Что это даёт по сравнению с поиском по словам:
Находит по смыслу. Человек спрашивает своими словами, совпадений нет, а ответ на сайте есть.
Терпит опечатки и синонимы.
Работает между формулировками. Вопрос и ответ написаны разными людьми в разном стиле.
Чего не даёт: понимания важности. Все найденные фрагменты «похожи», а насколько каждый отвечает на вопрос — вектор не измеряет.
Зачем сверху rerank
Здесь и лежит основной прирост качества.
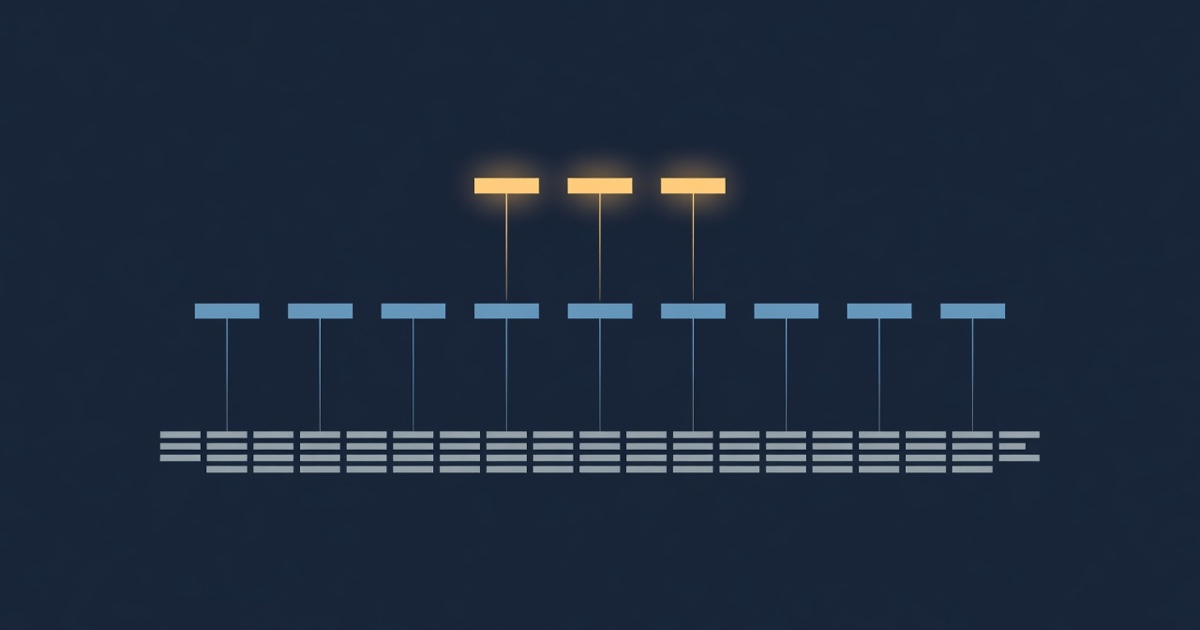
Векторный поиск работает быстро, потому что сравнивает векторы, а не тексты. Цена скорости — грубость: он отбирает кандидатов хорошо, а расставляет их по порядку плохо.
Переранжирование делает второй проход: берёт двадцать-пятьдесят кандидатов и оценивает каждую пару «запрос плюс фрагмент» целиком, а не через сжатое числовое представление. Медленнее, зато точнее — и на небольшом наборе это уже не дорого.
Практический вывод, который экономит много сил: связка «простой поиск плюс переранжирование» часто работает не хуже, чем векторный поиск без него — и не требует ни векторной базы, ни пересчёта индекса при каждом изменении содержимого. Механику мы разбирали, когда переранжирование появлялось в каталоге отдельной позицией — rerank: как улучшить поиск по документам.
Что важнее обоих слоёв
Разбиение текста на фрагменты. Скучно и решает больше всего.
Фрагмент должен быть самодостаточным. «Согласно пункту 4.7» без контекста бесполезен, каким бы способом его ни нашли.
Резать по смыслу, а не по числу символов. Раздел, подраздел, логический блок. Разрыв посреди мысли портит обе половины.
Заголовки — часть фрагмента. Они дают контекст, которого в самом абзаце нет.
Перекрытие небольшое. Чтобы мысль, попавшая на границу, не терялась.
Признак плохого разбиения виден сразу: найденные фрагменты формально по теме, а ответить по ним нельзя. Меняют при этом обычно модель — и не помогает.
Когда векторный поиск не нужен
Три случая, где сложность не окупается.
Мало содержимого. Сотни страниц — обычный поиск справляется, особенно с переранжированием сверху.
Запросы структурные. Люди ищут по параметрам, артикулам, названиям — тут точное совпадение лучше похожести.
Содержимое быстро меняется. Векторный индекс надо пересчитывать; на живом каталоге это отдельная работа.
Честный ориентир для перехода: тысячи фрагментов и свободные формулировки запросов. Ниже этого выигрыш обычно не окупает инфраструктуру.
Как это ложится на реальную задачу
Порядок сборки поиска по своим материалам.
- Разбейте содержимое по смыслу, с заголовками.
- Поднимите обычный поиск по словам — он уже что-то находит.
- Добавьте переранжирование поверх его результатов. Часто на этом можно остановиться.
- Измерьте. Двадцать реальных вопросов с известными правильными фрагментами: находится ли нужное в первой тройке.
- Только если не хватает — векторы. Тогда вы будете точно знать, чего именно не хватало.
Пятый шаг стоит соблюдать буквально: векторная база, поднятая до измерения, — это инфраструктура, про которую вы не знаете, нужна ли она.
Дальше найденные фрагменты идут в модель, которая формулирует ответ, — как устроен этот слой и как это выглядит на сайте.
Чего у нас нет
Прямо, потому что вопрос закономерный.
Моделей для построения эмбеддингов в каталоге KeyDealer нет. На 9 сентября 2026 года в нём 49 позиций в пятнадцати семействах, и позиций для векторизации среди них не значится. Если ваш проект строится на векторном поиске, эту часть придётся закрывать где-то ещё.
Переранжирование появлялось отдельной позицией — читать текущий состав каталога нужно в живой выдаче GET /v1/models, потому что он меняется: за последние сутки, например, число позиций сократилось.
Что у нас есть для этой задачи: модели, которые формулируют ответ по найденному, и их в каталоге достаточно — от 1 ₽ за миллион токенов, шесть текстовых позиций с нулевой ставкой.
Сколько это стоит
Три статьи расхода, и первая разовая.
Построение индекса. Один раз плюс досчёт при изменениях. Если векторов нет — этой статьи нет вовсе.
Поиск на запрос. У обычного поиска почти бесплатно, у векторного зависит от вашей инфраструктуры.
Ответ модели. Вопрос плюс три-пять фрагментов на входе, короткий ответ на выходе — тысячи токенов, единицы рублей на тысячу запросов — как считать.
Отсюда практическое: основной расход в этой связке — не модель. Оптимизировать стоит объём отправляемых фрагментов и число обращений, а не ставку за миллион.
Как измерить, работает ли поиск
Без замера вы будете улучшать наугад. Методика на вечер.
Соберите двадцать реальных вопросов. Из поддержки, из логов поиска, из переписки — не придуманных.
Для каждого укажите правильный фрагмент. Тот, где на самом деле лежит ответ. Это ваш эталон.
Померьте, попадает ли он в первую тройку. Именно тройку, а не первую позицию: модель всё равно получит несколько фрагментов.
Отдельно посчитайте случаи, где правильного фрагмента нет вовсе. Это не провал поиска, это дыра в содержимом — и чинится она текстом, а не техникой.
Повторяйте замер после каждого изменения. Разбиение, поиск, переранжирование — по одному изменению за раз.
Метрика простая и честная: доля вопросов, где нужный фрагмент попал в первую тройку. Если она ниже двух третей, добавлять модель поверх бессмысленно — она будет уверенно отвечать по неподходящим фрагментам, и это хуже, чем честное «не нашёл».
И держите выборку: она пригодится при каждом изменении содержимого, а не только при выборе способа поиска.
Чего мы не утверждаем
Не рекомендуем конкретные векторные базы и поисковые движки. Выбор зависит от объёма и стека.
Не сравниваем способы поиска по качеству. Мерить надо на своих вопросах и своём содержимом.
Не обещаем, что переранжирование заменит векторы во всех случаях. Мы утверждаем, что проверять надо в этом порядке.
Цифры каталога — на дату. Состояние на 9 сентября 2026 года.
Что нужно, чтобы проверить
Ключ заводится за минуту на keydealer.ru/login — почта и пароль, без документов и без зарубежной карты. Оплата российской картой в рублях, один ключ на весь каталог.
Проверить самое главное можно вообще без инфраструктуры: возьмите двадцать реальных вопросов, найдите фрагменты руками и посмотрите, собирается ли по ним нормальный ответ. Если нет — дело в содержимом, и никакой поиск этого не исправит. Платные текстовые модели для такой проверки доступны сразу на приветственном бонусе.
И честная оговорка про моду: векторный поиск стал синонимом «умного поиска», хотя решает только одну из трёх задач. Начинать с него — распространённый способ построить инфраструктуру раньше, чем выяснилось, какая проблема у вас на самом деле.
Что держать в голове
Порядок важности обратный привычному: разбиение содержимого, потом переранжирование, потом уже векторы. Начинать с эмбеддингов — значит строить инфраструктуру до того, как выяснилось, что она нужна.
И проверяйте связку вручную до всякой автоматизации: если по найденным вами же фрагментам ответ не собирается, проблема в материалах, а не в способе поиска.
Как мы проверяем факты и что храним из запросов — на странице о проекте и в llms.txt. Собрать ответ по своим фрагментам: keydealer.ru/login.
Частые вопросы
Что такое эмбеддинги простыми словами?
Числовое представление смысла текста. Похожие по смыслу фрагменты получают близкие наборы чисел, и поиск сводится к поиску ближайших.
Зачем нужен rerank, если есть векторный поиск?
Векторный поиск быстро отбирает кандидатов, но плохо расставляет их по порядку. Rerank пересортировывает небольшой набор точнее, потому что смотрит на пару «запрос и фрагмент» целиком.
Можно ли обойтись без эмбеддингов?
Часто да. На небольшом объёме обычный поиск по словам плюс переранжирование работает не хуже и обходится дешевле.
Есть ли эмбеддинги в каталоге KeyDealer?
Нет. Моделей для построения векторов у нас нет, и мы этого не скрываем; переранжирование в каталоге появлялось отдельной позицией.
Сколько данных нужно, чтобы векторный поиск окупился?
Ориентир — тысячи фрагментов и свободные формулировки запросов. На сотнях страниц выигрыш обычно незаметен.
Что важнее для качества ответа?
Разбиение текста на фрагменты. Плохо нарезанное содержимое портит результат сильнее, чем выбор способа поиска.