LLM API и интеграция
Маршрутизация между моделями: дешёвая и сильная
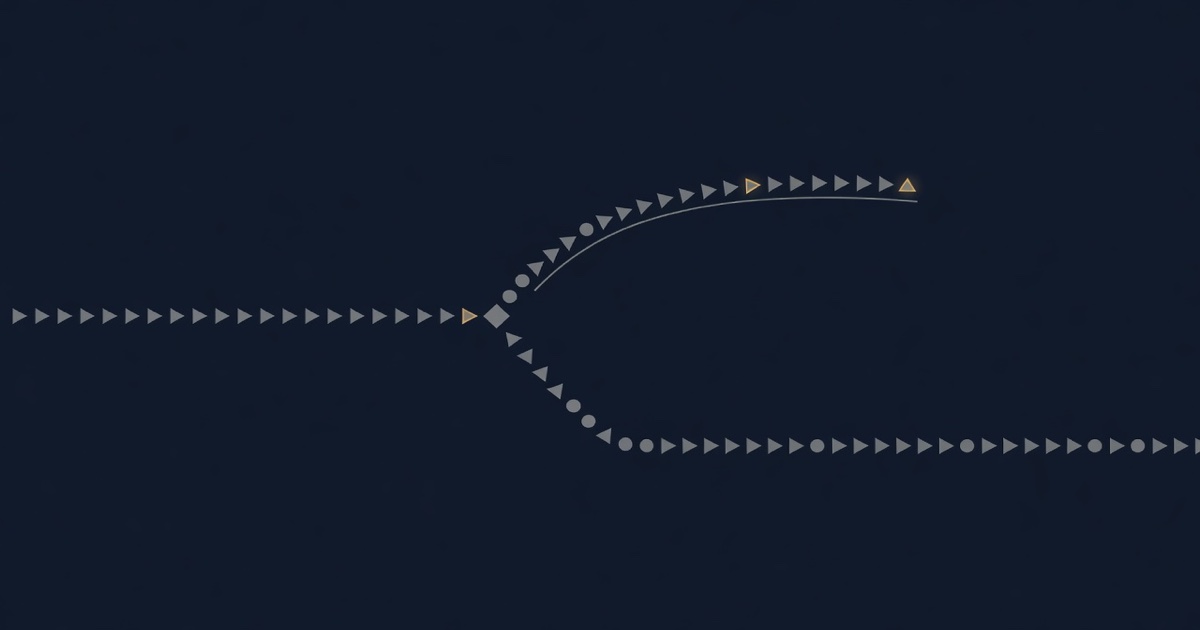
Одна модель на все задачи — самое распространённое и самое дорогое решение в интеграции. Поток запросов почти всегда неоднороден: восемьдесят процентов составляют типовые задачи, где разница между дешёвой и дорогой позицией не видна, и двадцать — сложные, где она решает всё. Платить за все сто по верхней ставке — значит переплачивать за большинство. Маршрутизация решает это в несколько десятков строк кода: простое уходит вниз, сложное вверх, а неудача внизу поднимается наверх автоматически. Разбираем, по каким признакам разводить, где граница и почему угадывать сложность заранее не нужно.
Зачем это нужно
Арифметика простая и от неё трудно отмахнуться.
В каталоге на 7 сентября 2026 года платные текстовые позиции идут от 1 до 180 ₽ за миллион токенов. Разрыв между нижней и верхней ставкой — стократный, а между «недорогой рабочей» и «флагманской» обычно от трёх до шести раз.
Теперь возьмите свой поток. Если в нём есть классификация обращений, извлечение полей, короткие ответы по шаблону — это большинство запросов, и они не требуют сильной модели. А платите вы за них столько же, сколько за разбор сложного случая.
Отсюда правило: маршрутизация окупается тем сильнее, чем однороднее выглядит поток снаружи и чем неоднороднее он на самом деле.
По каким признакам разводить
Простые признаки работают лучше умных. Пять, которые реально помогают.
Тип задачи. Самый надёжный признак, если у вас несколько сценариев. Классификация — вниз, разбор договора — вверх. Никакой догадливости не требуется: сценарий известен вашему коду.
Длина запроса. Длинный контекст обычно означает сложную задачу. Плюс на длинных запросах экономия от дешёвой ставки максимальна.
Наличие вложений. Картинка или документ на входе — почти всегда более трудный случай.
Глубина диалога. Первые реплики простые, к десятой накопился контекст и появились нюансы.
Явное указание пользователя. Кнопка «разобрать подробнее» — честный и дешёвый способ переложить решение на того, кто знает задачу.
Чего делать не стоит: ставить отдельную модель-классификатор для оценки сложности. Она добавляет вызов, задержку и собственные ошибки, а выигрывает у простых правил редко.
Эскалация вместо угадывания
Приём, который решает проблему лучше любой классификации.
Не пытайтесь определить сложность заранее. Отправьте запрос на дешёвую модель и проверьте результат. Не прошёл проверку — повторите на сильной.
Что считать неудачей, зависит от задачи:
Формат не соблюдён. При строгом выводе видно сразу — как его получить.
Модель ответила «не знаю». Если вы дали ей легальный способ признаться, это честный сигнал к эскалации.
Проверка в коде не прошла. Число не сошлось, идентификатор не найден, обязательное поле пустое.
Низкая уверенность. Если вы просите её отдельным полем.
Экономика эскалации приятная: вы платите дважды только за ту долю запросов, которая реально сложная. При восьмидесяти процентах простых суммарный счёт всё равно заметно ниже, чем при отправке всего потока наверх.
Где граница
Три ситуации, когда маршрутизация не нужна.
Поток однородный. Все запросы одного типа и одной сложности — разводить нечего.
Объём маленький. При сотне запросов в день экономия не покроет усложнения кода.
Ошибка внизу дорога и необратима. Если неудачная попытка дешёвой модели уже что-то испортила, эскалация не спасает. Тогда всё идёт наверх сразу.
Признак, что пора: вы смотрите на счёт и видите, что основную сумму дал сценарий, который вы считали простым. Раздельные ключи по сценариям показывают это без разбора логов — как их разводить.
Что нужно, чтобы это работало
Пять требований к реализации.
Идентификаторы моделей в конфигурации. Не в коде. Позиции появляются и уходят: за последние сутки в нашем каталоге одна модель исчезла и вернулась — почему переезд надо делать дешёвым.
Единый интерфейс. Если модели доступны по одному совместимому протоколу, маршрутизация — это выбор строки, а не две интеграции.
Логирование маршрута. По каждому запросу: куда ушёл, была ли эскалация, чем закончилось. Без этого вы не узнаете, работает ли схема — что писать в логи.
Выборка для проверки. Прежде чем спускать сценарий вниз, убедитесь, что дешёвая модель на нём справляется — как измерять.
Предел эскалаций. Один повтор наверх, а не цепочка.
Сколько это экономит
Считать надо на своих цифрах, но порядок показать полезно.
Возьмём поток из тысячи запросов в день: восемьсот простых, двести сложных. Пусть дешёвая позиция стоит 3 ₽ за миллион, а сильная — 30 ₽, то есть в десять раз дороже.
Всё наверх: тысяча запросов по верхней ставке.
С маршрутизацией: восемьсот по нижней, двести по верхней, плюс эскалация условно с десятой части простых — ещё восемьдесят по верхней.
Даже с эскалацией по верхней ставке проходит меньше трети потока вместо всего. При десятикратной разнице ставок это и есть основная часть счёта.
Точный расчёт под ваш профиль — как считать токены и стоимость миллиона.
Побочная выгода: устойчивость
О ней вспоминают позже, а стоит она не меньше экономии.
Код, умеющий работать с несколькими моделями, автоматически умеет пережить отказ одной из них. Маршрут не отвечает — запрос уходит на соседний. Модель отключили — правка конфигурации вместо релиза.
Это ровно та защита, которая нужна при нынешней частоте изменений: за неделю в каталоге уходили и приходили позиции, у вендоров закрывались целые линейки — что произошло с Kimi K2.5. Механику отказов и повторов разбирали отдельно — коды, повторы и fallback.
Как это выглядит в коде
Без привязки к языку — структура решения, которая обычно и получается.
Уровень первый: правило по сценарию. Словарь «тип задачи → модель» в конфигурации. Покрывает большинство случаев и не требует никакой логики.
Уровень второй: поправка по признакам. Длина запроса выше порога или есть вложение — поднять на уровень выше. Пара условий.
Уровень третий: эскалация по результату. Проверка ответа не прошла — повтор на сильной модели. Один раз, не цепочкой.
Уровень четвёртый: запасной маршрут. Модель недоступна — соседняя позиция того же класса.
Первые два уровня пишутся за час и дают основную экономию. Третий добавляется, когда появятся данные о том, где именно дешёвая модель не справляется. Четвёртый — когда сценарий станет боевым.
Чего делать не стоит: строить маршрутизацию до того, как появился поток. На старте вы не знаете, какие запросы у вас простые, и разведение будет угадыванием. Правильный порядок — сначала один маршрут и логи, через пару недель разбор логов, и только потом правила.
Отдельно про логи: записывайте не только выбранный маршрут, но и почему он выбран. Через месяц это будет единственный способ понять, почему конкретный запрос ушёл наверх, — и заодно основа для пересмотра порогов.
Чего мы не утверждаем
Не даём готовых правил маршрутизации. Они зависят от вашего потока; признаки выше — отправная точка.
Не сравниваем модели по качеству. Своих замеров мы не делали; какая позиция справится с вашим «простым», проверяется на выборке.
Не обещаем конкретной экономии. Она определяется долей простых запросов и разницей ставок в вашем случае.
Цифры каталога — на дату. Состояние на 7 сентября 2026 года.
Что нужно, чтобы начать
Ключ заводится за минуту на keydealer.ru/login — почта и пароль, без документов и без зарубежной карты. Главное для этой задачи: один ключ на весь каталог, 56 позиций в шестнадцати семействах. Маршрутизация между Claude, GPT, Gemini, Grok и открытыми весами — выбор строки в запросе, без отдельных договоров и интеграций.
Платные текстовые модели доступны сразу на приветственном бонусе, восемь позиций тарифицируются по нулевой ставке после пополнения от 100 ₽ — на них удобно проверить, справляется ли нижний уровень с вашим «простым».
Что держать в голове
Поток почти всегда неоднороден, а платят за него по единой верхней ставке. Разведение по сложности — несколько десятков строк кода и обычно основная часть экономии.
И не угадывайте сложность заранее: отправляйте вниз, проверяйте результат, поднимайте наверх при неудаче. Эскалация надёжнее классификации и не требует лишнего вызова.
Как мы проверяем факты и что храним из запросов — на странице о проекте и в llms.txt. Проверить нижний уровень на своих задачах: keydealer.ru/login.
Частые вопросы
Что такое маршрутизация между моделями?
Схема, при которой простые запросы уходят на дешёвую модель, а сложные на сильную. Решение принимает ваш код по признакам запроса, а не пользователь.
Насколько это экономит?
Зависит от доли простых запросов. Если восемьдесят процентов потока — типовые задачи, а разница в ставке кратная, экономия составляет большую часть счёта.
Как определить, какой запрос сложный?
Простые признаки работают лучше сложных: длина запроса, тип задачи, наличие вложений, история диалога. Отдельная модель-классификатор обычно не окупается.
Что делать, если дешёвая модель не справилась?
Повторить на сильной. Схема с эскалацией надёжнее попытки угадать сложность заранее.
Нужны ли для этого разные договоры?
Нет, если модели доступны по одному ключу. В каталоге KeyDealer на 7 сентября 2026 года 56 позиций, переключение — смена строки в запросе.