LLM API и интеграция
Нейросеть для закупок: сравнение КП и спецификаций
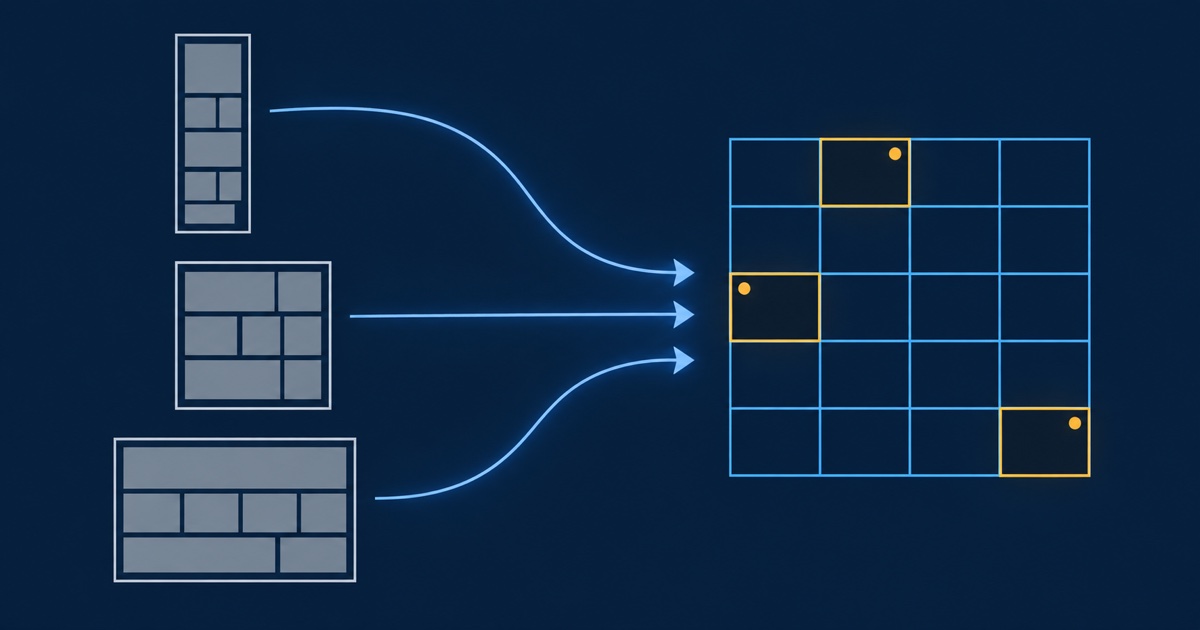
Языковая модель в закупках делает одну работу, которая съедает больше всего времени: приводит разнородные коммерческие предложения к одной таблице и показывает, где позиции на самом деле не сопоставимы. Разбор ста КП в месяц стоит около 3 ₽ на ставке 3 ₽ за миллион токенов, тогда как ручное сведение того же объёма занимает у специалиста несколько рабочих дней.
Выбор поставщика при этом остаётся за человеком, и не из перестраховки. У модели нет данных о том, как этот поставщик срывал сроки в прошлом квартале и почему по одной категории вы принципиально не работаете с посредниками. Она готовит таблицу, решение принимается по ней.
В чём настоящая проблема сведения КП
Не в арифметике. Сложить цены умеет Excel. Проблема в том, что предложения приходят несопоставимыми, и это выясняется уже после выбора.
Три предложения на одну и ту же позицию отличаются по четырём осям сразу: наименование написано по-разному, единица измерения своя у каждого, комплектация отличается на одну деталь, а условия — доставка, срок, гарантия, НДС — спрятаны в тексте вне таблицы. Закупщик тратит время не на сравнение, а на приведение к общему виду, и именно на этом этапе теряются расхождения.
Вот эту работу модель и берёт. Причём главный результат — не сама таблица, а список мест, где сопоставление получилось неточным: «у поставщика Б в позиции 4 указана комплектация без крепежа, у остальных крепёж включён».
Как устроен разбор
Порядок из четырёх шагов, каждый отдельным запросом.
Шаг первый — извлечение. Из каждого файла вытаскиваются позиции: наименование как есть, количество, единица, цена за единицу, сумма. Ничего не нормализуется, ничего не додумывается. Работа со сканами и PDF разобрана отдельно в материале как обработать PDF через API.
Шаг второй — условия. Из текста вне таблицы вытаскиваются срок поставки, условия оплаты, доставка, гарантия, НДС. Это то, что чаще всего забывают в сравнении, а потом оно оказывается решающим.
Шаг третий — нормализация. Наименования приводятся к общему виду, единицы пересчитываются, позиции сопоставляются между поставщиками. Здесь модель обязана помечать неуверенные сопоставления, а не молча склеивать похожее.
Шаг четвёртый — сводная таблица и список расхождений. Дальше работает человек.
Как сверять спецификацию с техзаданием
Это вторая по ценности задача и технически она проще. Есть требования из ТЗ и есть спецификация из предложения. Нужно построчно показать: требование выполнено, не выполнено, выполнено частично, не упомянуто вовсе.
Последняя категория — самая важная. Поставщик редко пишет «этого нет»: он просто не упоминает пункт, и при быстром чтении это выглядит как согласие. Построчная сверка вытаскивает такие пропуски. Механика та же, что в разборе сравнение документов нейросетью.
Отдельно полезно делать обратную операцию: сверять своё ТЗ с полученными предложениями до объявления следующей закупки. Если все четыре поставщика одинаково «не заметили» один и тот же пункт, скорее всего пункт сформулирован непонятно.
Что делать с перепиской и запросами
Запрос коммерческого предложения — документ шаблонный, и его подготовка отнимает время только из-за подстановки номенклатуры. Модель собирает запрос из позиции плюс требования и выдаёт готовый текст, который остаётся проверить. Смежный сценарий описан в материале нейросеть для коммерческого предложения.
Полезнее другое — разбор входящей переписки. Поставщик пишет «сроки могут сдвинуться в связи с загрузкой производства», и это тонет в цепочке писем. Классификация писем по типу события — подтверждение, сдвиг срока, изменение цены, запрос документов — даёт ленту событий по каждой закупке, которую иначе никто не ведёт.
Как готовиться к тендерной документации
Крупная закупочная документация — это сотни страниц, из которых к вашей заявке относятся два десятка пунктов. Задача модели здесь не «прочитать за вас», а собрать чек-лист требований: что приложить, в каком формате, к какому сроку, с какими подписями.
Порядок такой же, как со спецификацией: сначала извлечение требований построчно, потом сверка с тем, что у вас уже готово, потом список пробелов. Каждое требование в чек-листе должно нести ссылку на пункт исходного документа — без этого проверить его невозможно, а проверять придётся.
Обратная сторона — подготовка документации, когда закупку объявляете вы. Здесь полезно прогнать черновик ТЗ и спросить, какие требования сформулированы так, что допускают несколько толкований. Это не юридическая экспертиза, а вычитка на двусмысленность, и она хорошо ловит места, где поставщики потом «не заметят» пункт.
Какие ошибки повторяются
Три, и все они дорогие.
Просят модель сделать всё одним запросом: извлечь, нормализовать, сравнить и порекомендовать. На длинной цепочке в одном ответе ошибки первого шага переносятся в последний и становятся невидимыми. Шаги разделяют, чтобы каждый можно было проверить отдельно.
Не задают формат вывода. Если не сказать, какие поля нужны и что делать с отсутствующими, модель каждый раз выдаёт немного другую структуру, и таблица не собирается. Поля перечисляются явно, для пустых заранее оговаривается прочерк.
Верят цифрам, которые не проверяли на сумме. Простейшая защита от ошибок извлечения — пересчёт: количество на цену должно давать сумму из документа. Расхождение означает, что позиция извлечена неверно, и ловится это автоматически, без чтения.
Сколько это стоит
Расчёт на месяц для отдела закупок среднего размера, курс ЦБ 84,3363 ₽ за доллар.
| Задача | Объём в месяц | Токенов на документ | Ставка | Стоимость |
|---|---|---|---|---|
| Разбор КП | 100 | ~4800 | 3 ₽/М | ≈ 3 ₽ |
| Сверка спецификации с ТЗ | 40 | ~9000 | 8 ₽/М | ≈ 3 ₽ |
| Классификация переписки | 800 писем | ~900 | 1 ₽/М | ≈ 1 ₽ |
| Подготовка запросов | 120 | ~1500 | 6 ₽/М | ≈ 1 ₽ |
| Итого | ≈ 8 ₽ |
Порядок величин здесь тот же, что и в других документных задачах: обработка стоит рубли, а экономится время специалиста. Как считается сам расход, разобрано в материале сколько стоит миллион токенов в рублях.
Для такой нагрузки не нужна ни своя инфраструктура, ни подписка на отдельный сервис под каждую задачу. KeyDealer даёт один ключ на каталог из 53 позиций, из которых 40 доступны сейчас, с оплатой российской картой в рублях и ставками от 1 ₽ за миллион токенов. Разбор КП, сверка спецификаций и классификация писем идут через один и тот же ключ, а расход виден по каждому запросу.
Что меняется в работе отдела
Не число людей, а распределение внимания. До внедрения закупщик читает все предложения одинаково подробно, потому что заранее не знает, где подвох. После — читает подробно те места, которые подсветил разбор, и бегло остальное.
Второе изменение менее очевидное: появляется история в сопоставимом виде. Когда каждая закупка сведена в одинаковую структуру, через полгода можно ответить на вопросы, которые раньше требовали поднимать папки: как менялась цена по категории, кто из поставщиков регулярно сдвигает сроки, по каким позициям предложений стабильно меньше трёх.
Где модели доверять нельзя
Четыре места, и они не про качество модели, а про природу задачи.
Проверка контрагента. ИНН, ОГРН, дата регистрации, статус в реестрах — только из официальных источников. Названные моделью по памяти реквизиты могут быть правдоподобными и неверными одновременно.
Рыночная цена. Модель не знает сегодняшних цен и не должна их называть. Если в ответе появилась «средняя рыночная цена по категории» — это выдумка, а не данные.
Юридическая квалификация. Ссылки на статьи 44-ФЗ и 223-ФЗ, сроки обжалования, требования к обеспечению — всё это проверяется по первоисточнику. Смежный разбор рисков — в материале нейросеть для юриста: договоры.
Итоговый выбор. Даже если по таблице победитель очевиден, подпись под решением ставит человек, и в закупках это не формальность.
Чего мы не утверждаем
Мы не утверждаем, что модель заменит систему электронных закупок. Она не ведёт реестр, не хранит историю и не подписывает документы — она обрабатывает то, что в эту систему попадает или из неё выгружается.
Мы не утверждаем, что разбор будет стопроцентно точным на любых файлах. Плохо отсканированные таблицы, объединённые ячейки и предложения, свёрстанные в картинках, дают ошибки. Именно поэтому в результате нужны пометки о неуверенности, а не только цифры.
Мы не утверждаем, что это снимает необходимость читать документы. Это снимает необходимость читать все документы одинаково внимательно: внимание перераспределяется на подсвеченные расхождения.
Что нужно, чтобы попробовать
Ключ на keydealer.ru/login и один прошедший тендер, где было хотя бы четыре предложения. Прогоните их через разбор и сравните с таблицей, которую сводили руками. Если модель нашла расхождение, которое пропустили, — это и есть ответ по целесообразности. Работа с таблицами на выходе описана в материале нейросеть в Excel: формулы и таблицы.
Что держать в голове
Первое. Ценность не в том, что модель считает быстрее, а в том, что она не устаёт на восьмом предложении. Ручное сведение ломается ровно там, где предложений много и они разнородны, — то есть в самых дорогих закупках.
Второе. Пометки о неуверенности важнее самих цифр. Таблица без них создаёт ложное ощущение сопоставимости и в этом опаснее ручного разбора. Требуйте их в промте явно.
Третье. Всё, что касается реквизитов, права и денег, проверяется по первоисточнику независимо от того, насколько уверенно звучит ответ. Что мы за проект и на каких условиях работаем — на странице о проекте, ключ заводится на keydealer.ru/login.
Частые вопросы
Может ли нейросеть выбрать поставщика?
Нет, и это не осторожность, а разделение ролей. Модель сводит предложения в сопоставимый вид и показывает расхождения, но у неё нет данных о надёжности контрагента, истории поставок и внутренних приоритетах компании. Решение принимает закупщик, модель готовит для него таблицу.
Как модель сводит разные коммерческие предложения в одну таблицу?
Через нормализацию наименований и единиц. Одна и та же позиция у трёх поставщиков называется по-разному, идёт в разных единицах и с разной комплектацией. Модель приводит их к одному виду и помечает места, где сопоставление неточное, — вот эти пометки и есть самое ценное в результате.
Можно ли доверять модели проверку контрагента?
Нет. Сведения о юридическом лице берутся из официальных реестров, а не из ответа модели: любая цифра ИНН или дата регистрации, названная моделью по памяти, может быть выдуманной. Модель полезна на другом шаге — разобрать уже выгруженные документы и подсветить, что в них смущает.
Сколько стоит разбор ста коммерческих предложений?
Около 3 ₽ в месяц на дешёвой позиции. Одно КП на две-три страницы — это примерно 4000 входных и 800 выходных токенов, сто предложений дают меньше полумиллиона токенов. Основной расход в закупках — это не токены, а часы специалиста, которые уходят на ручное сведение.
Подходит ли это для госзакупок по 44-ФЗ?
Для подготовки — да, для решения — нет. Разобрать документацию, вытащить требования в чек-лист и сверить с ним свою заявку модель может. Но юридическую квалификацию по 44-ФЗ и 223-ФЗ делает специалист: ссылки на статьи и сроки, названные моделью без первоисточника, проверять обязательно.
С чего начать, если закупки ведутся в почте и Excel?
С одной категории номенклатуры. Возьмите последний тендер, где было хотя бы четыре предложения, и попробуйте свести их в таблицу через модель. Сравните с тем, что сводили руками. Разница во времени и в найденных расхождениях покажет, стоит ли расширять.