LLM API и интеграция
Сколько примеров давать нейросети в промте
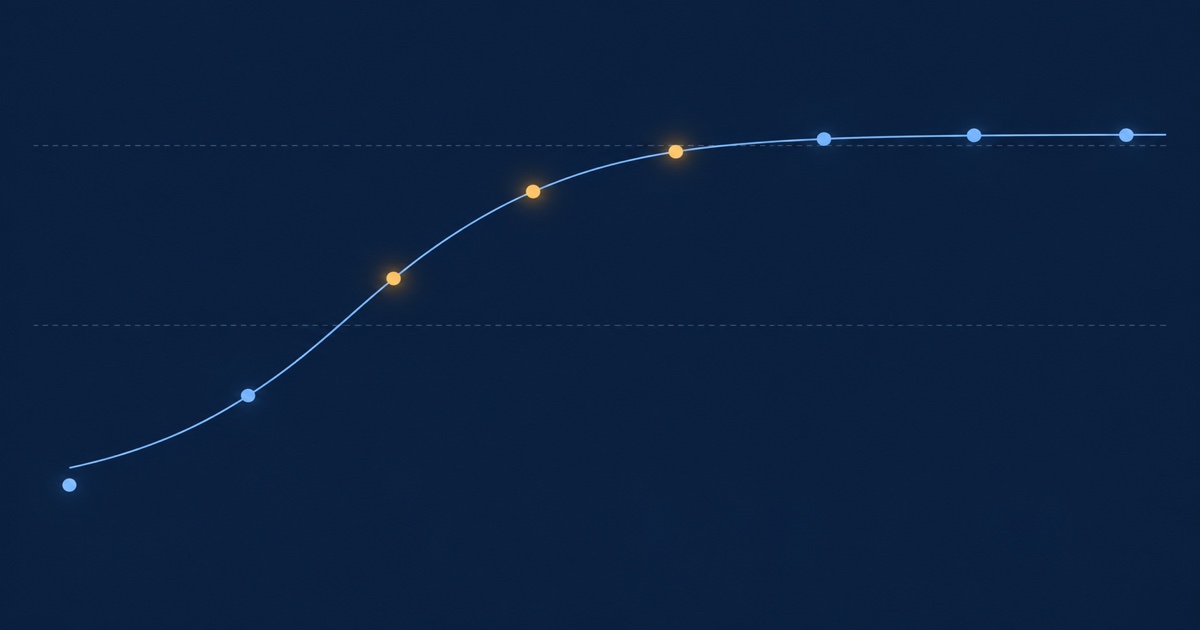
Рабочий диапазон — от 3 до 5 примеров: один пример чаще вредит, чем помогает, а после 5–8 прирост качества почти исчезает. Под классификацию берут по 2 примера на класс, под формат ответа хватает двух, под стиль нужно 5 и больше, и каждый пример оплачивается заново на каждом запросе. Число подбирают замером, а не по правилу.
Дальше — чем пример отличается от инструкции, почему единственный образец ухудшает результат, откуда берётся перекос в однотипных наборах, таблица с нормой под разные задачи, расчёт стоимости и признаки того, что примеры пора хранить вне промта. Про сами приёмы формулировки есть отдельный разбор — промпт-инжиниринг: что работает; про то, куда примеры класть, — как написать системный промпт. Здесь задача другая: не «какие приёмы применять», а «сколько образцов положить и что это стоит».
Чем пример отличается от инструкции
Инструкция описывает правило, пример показывает результат. Это разные способы передать одно и то же требование, и они по-разному переносятся.
Инструкция «отвечай кратко» оставляет модели решать, что такое кратко. Два примера, где ответ занимает одну строку, снимают вопрос без определения. Там, где требование легко описать словами — «не упоминай конкурентов», «всегда указывай валюту», — инструкция короче и надёжнее. Там, где описание получается громоздким — тон, ритм, структура, разметка, — пример дешевле абзаца требований.
Практическое следствие: примеры и инструкции не конкурируют, а покрывают разные части задачи. Плохо, когда весь промпт состоит из запретов и ни одного образца. Плохо и обратное — когда десять примеров стоят вместо двух строк правил, которые можно было написать прямо.
Ещё одно отличие важно для счёта. Инструкция пишется один раз и обычно коротка. Примеры занимают в разы больше места и уходят в модель при каждом обращении. К этому вернёмся в разделе про деньги.
Почему один пример часто хуже, чем ни одного
Один пример модель копирует целиком, вместе со случайными его признаками. Это самый частый способ испортить промпт, добавив в него «улучшение».
Механика простая. Без примеров модель опирается на инструкцию и на собственное представление о задаче — ответ получается усреднённым, но ровным. С одним примером у неё появляется единственный образец, и она воспроизводит его форму: ту же длину, тот же порядок частей, ту же интонацию, иногда даже ту же тему. Если ваш единственный пример был про возврат товара, часть ответов начнёт съезжать в сторону возвратов там, где речь о доставке.
Особенно заметно это в задачах с выбором. Один пример с ответом «да» смещает распределение в сторону «да». Один пример длиной в абзац делает абзацем все ответы, включая те, где хватило бы слова.
Вывод для практики: если примеров меньше двух, лучше не ставить ни одного и дожать инструкцией. Два примера уже дают модели понять, что именно в них общее, а что случайное. Три-пять — рабочая норма.
Откуда берётся перекос, когда все примеры похожи
Перекос берётся из формы, а не из содержания. Модель копирует структуру примеров охотнее, чем их смысл, и однотипный набор превращается в скрытое ограничение.
Типичная картина: автор промпта взял пять примеров из одной папки, за один день, по одному типу обращений. Все они средней длины, все с вежливым началом, во всех по три пункта. Модель делает из этого правило «ответ состоит из трёх пунктов» и начинает придумывать третий пункт там, где по делу хватает одного.
Тот же эффект в классификации: если в наборе примеров восемь случаев класса A и по одному на классы B и C, модель заметно чаще отвечает A. Она читает набор не только как образец формата, но и как подсказку о том, что обычно бывает.
Что с этим делают:
- Разная длина. В набор кладут короткий, средний и длинный случай. Иначе длина фиксируется случайно.
- Разный тип случая. Простой, типовой и пограничный — тот, на котором модель обычно ошибается.
- Равные классы. Для задач с категориями число примеров на класс держат одинаковым.
- Отрицательные примеры с пометкой. Если показываете, как не надо, подписывайте это прямо; иначе модель скопирует и их.
Проверка набора занимает минуту: прочитайте примеры подряд и спросите себя, чем они друг от друга отличаются. Если ответ «ничем, кроме слов» — набор однотипный.
Сколько примеров нужно под конкретную задачу
Норма зависит не от сложности задачи, а от того, что именно вы передаёте примером: категорию, форму или манеру. Таблица — стартовые значения, от которых имеет смысл отталкиваться и дальше проверять на своей выборке.
| Что передаёте примером | Сколько брать | На что смотреть при проверке |
|---|---|---|
| Категорию (классификация, маршрутизация) | по 2 на класс, пограничные +1 | доля ошибок по каждому классу отдельно |
| Формат ответа (структура, поля) | 2, иногда 3 | разбирается ли ответ по схеме без ручной правки |
| Стиль и тон | 5 и больше | чувствуется ли манера на текстах вне выборки |
| Разбор сложного случая (рассуждение) | 1–2 развёрнутых | воспроизводится ли ход разбора, а не только вывод |
| Извлечение данных из текста | 3–4 с разной полнотой | что модель делает, когда поля в тексте нет |
| Перевод внутренних правил компании | 3–5 | не путает ли редкие исключения с общим правилом |
Таблица читается и в отрыве от статьи: по ней можно собрать первый набор примеров и дальше подбирать число замером.
Сколько примеров нужно для классификации
По два на каждый класс как стартовая точка, а дальше — по ошибкам. Классификация — единственная из задач, где число примеров считается не общим списком, а по категориям.
Логика такая. Пять классов при двух примерах на класс дают десять примеров — это уже заметный промпт, но результат обычно оправдывает длину. Класс без единого примера модель систематически занижает, даже если он описан в инструкции. Класс с тремя примерами, когда у остальных по два, она начинает переоценивать.
Третий пример добавляют адресно — в тот класс, который путается с соседним, и обязательно пограничный. Пример, который очевиден человеку, модели ничего не сообщает; полезен тот, на котором вы сами задумались. Практика разметки и подбора порогов разобрана в статье про классификацию текстов нейросетью.
Отдельный случай — классы, которых в примерах быть не может, потому что они редкие. Тогда лучше описать их инструкцией и оставить модели явный выход «не подходит ни под один класс», чем пытаться подобрать образец.
Сколько нужно, чтобы зафиксировать формат ответа
Двух примеров почти всегда достаточно, и это самая дешёвая часть набора. Формат — то, что модель схватывает быстрее всего.
Два примера с одинаковой структурой и разным содержанием показывают, где в форме постоянная часть, а где переменная. Третий имеет смысл добавлять только для одного случая: когда какое-то поле бывает пустым. Тогда третий пример показывает, чем именно его заполнять — нулём, пустой строкой или отсутствием ключа.
Важное ограничение: примеры не заменяют строгую схему. Если ответ разбирается программой, формат задают средствами протокола, а примеры только помогают модели попадать в него чаще. Как добиться предсказуемой структуры — в разборе строгого JSON от нейросети.
Сколько нужно, чтобы передать стиль
Пять и больше, и это единственная задача, где длинный набор оправдан. Стиль складывается из мелочей, которые по двум образцам не читаются.
Разница со форматом принципиальная. Формат — это правило, которое видно с первого взгляда. Стиль — распределение: длина фраз, доля вопросов, наличие цифр, готовность признавать неопределённость. Чтобы модель уловила распределение, ей нужно несколько точек.
Отсюда практический приём: для стиля берут примеры, разные по теме, но одинаковые по манере. Если все пять про одно и то же, модель выучит тему вместо тона. Если все пять разной длины и написаны в одном голосе — она возьмёт именно голос.
И оговорка. Стиль, который вы сами не можете описать, примерами передаётся частично. Разброс между запусками никуда не денется, и на одном и том же промпте ответы будут отличаться — почему так, разобрано отдельно в статье о том, почему модель отвечает по-разному.
Сколько это стоит на каждом запросе
Примеры оплачиваются как входные токены при каждом обращении — это их главное отличие от инструкции по цене. Считается это в одну строчку.
Возьмём набор из пятнадцати примеров по 150 токенов каждый. Это 2250 токенов сверху в каждом запросе. При миллионе запросов в месяц — 2,25 миллиарда входных токенов только на примеры. На позиции за 3 ₽ за миллион токенов это одна сумма, на позиции за 30 ₽ — принципиально другая. Для сценариев поменьше арифметика та же, просто числа мельче: тысяча запросов в день с тем же набором даёт 2,25 миллиона токенов в день.
Отсюда два следствия. Первое: разница между тремя примерами и пятнадцатью — это не «чуть длиннее промпт», а множитель на счёте, который работает каждый день. Второе: на дешёвых позициях длинный набор допустим, на дорогих его сокращают первым делом. Как считать сами токены — в статье как считать токены.
Часть этой суммы снимает кэш: если набор примеров стоит в начале запроса и не меняется, повторяющийся префикс тарифицируется по льготной ставке. Условие одно — переменная часть идёт последней, иначе кэш не срабатывает вовсе. Механика разобрана в кэше промптов.
Сколько примеров давать, в итоге решает замер, а не правило: три-пять для большинства задач, по два на класс для классификации. Проверять это дешевле на одном ключе — в KeyDealer 53 позиции каталога, 40 доступны сейчас, оплата российской картой в рублях, и расход по каждому варианту промпта виден в общем журнале.
Как проверить своё число примеров
Замером на выборке, а не ощущением от пары ответов. Проверка укладывается в час и снимает спор о числе примеров окончательно.
Порядок действий:
- Соберите 30–50 реальных запросов с известными правильными ответами. Не придуманных — настоящих, включая неудобные.
- Прогоните выборку в четырёх вариантах: без примеров, с двумя, с пятью, с десятью. Промпт в остальном не трогайте.
- Посчитайте долю верных ответов и среднюю длину промпта для каждого варианта.
- Выберите точку, после которой прирост меньше, чем рост цены. Обычно она находится между тремя и пятью.
Один прогон ничего не доказывает: разброс между запусками на одном и том же промпте бывает больше, чем разница между двумя и пятью примерами. Поэтому выборка, а не единичная проверка. Как строить такие прогоны — в разборе как тестировать нейросеть.
Когда примеры пора выносить в поиск по базе
Когда их больше пятнадцати-двадцати, когда они устаревают быстрее, чем вы правите промпт, или когда нужный пример зависит от конкретного запроса. Это три независимых признака, любого из них достаточно.
Схема замены такая: примеры хранятся отдельно, а в промпт при каждом запросе подставляются три-пять наиболее близких к текущему входу. Промпт остаётся коротким, набор примеров может расти без предела, и обновляется он правкой базы, а не правкой кода. Механика подбора разобрана в статье про поиск по своей базе, а качество подбора — в разборе эмбеддингов и переранжирования.
Плата за это — сложность. Появляется хранилище, появляется этап подбора, появляется новая причина плохого ответа: подобрались не те примеры. Пока примеров меньше десяти и они одинаково полезны для любого запроса, статический набор в промпте проще и предсказуемее.
Третий вариант, о котором вспоминают реже: если примеров тысячи и они стабильны, задача может оказаться не про промпт вовсе. Граница между подбором примеров и дообучением разобрана в статье дообучение или промпт.
Ошибки, которые повторяются
Примеры вместо инструкции везде. Требования, которые формулируются одной строкой, дешевле написать строкой. Пример нужен там, где описание получается длиннее образца.
Примеры из одного дня. Набор, собранный из соседних строк журнала, почти всегда однотипен по форме. Берите случаи из разных периодов и разных типов.
Примеры, которые противоречат инструкции. Модель в такой ситуации чаще слушает пример. Если в правилах «не более трёх предложений», а в примере их пять — работать будет пятёрка.
Примеры, которые никто не пересматривал полгода. Они устаревают вместе с продуктом: старые названия, снятые тарифы, изменившиеся правила. Устаревший пример хуже отсутствующего, потому что он уверенно тиражирует неправду.
Чего мы не утверждаем
Мы не утверждаем, что три-пять — универсальная норма. Это точка, с которой разумно начинать; на узких задачах с чёткой инструкцией выигрывает ноль примеров, на передаче манеры — десять.
Мы не утверждаем, что число примеров переносится между моделями. Набор, подобранный под одну позицию, на другой может оказаться и избыточным, и недостаточным; проверять приходится заново.
Мы не приводим вендорских замеров качества и не сравниваем модели по «понятливости». Такие сравнения зависят от выборки и задачи, и честный ответ здесь даёт только ваш собственный прогон.
Что нужно, чтобы попробовать
Ключ заводится за минуту на keydealer.ru/login — почта и пароль, без документов и без зарубежной карты. Оплата российской картой в рублях, один ключ на весь каталог.
Прогон выборки в четырёх вариантах — недорогая процедура. Пятьдесят запросов на дешёвой позиции стоят копейки, а решение о числе примеров принимается один раз и работает потом каждый день. Пять текстовых позиций каталога бесплатны после первого пополнения, и обкатать методику проверки можно на них.
Что держать в голове
Пример передаёт форму, инструкция передаёт правило. Всё, что легко описать словами, дешевле описать словами: примеры оплачиваются на каждом запросе, инструкция — тоже, но она короче.
Один пример хуже нуля, потому что модель копирует его целиком, включая случайные черты. Два — минимум, три-пять — рабочая норма, для классификации считают по два на класс, для стиля берут пять и больше.
Когда примеров становится больше пятнадцати или они зависят от запроса, их выносят в базу и подставляют подходящие. Как мы проверяем факты и почему у каждой цифры стоит дата — на странице о проекте. Завести ключ и прогнать свою выборку: keydealer.ru/login.
Частые вопросы
Сколько примеров давать нейросети в промте?
Рабочий диапазон — три-пять. Для классификации считают иначе: по два примера на каждый класс. Для формата ответа хватает двух, для стиля нужно пять и больше. Точное число подбирают замером на своей выборке, а не по правилу из статьи.
Почему один пример хуже, чем ни одного?
Потому что модель копирует единственный образец целиком, вместе со случайными его чертами — длиной, порядком полей, интонацией, даже темой. Без примеров она опирается на инструкцию и ведёт себя ровнее. Один пример задаёт не правило, а частный случай.
Сколько примеров нужно для классификации?
По два на каждый класс как стартовая точка. Для пяти классов это десять примеров. Если какой-то класс путается с соседним, добавляют туда третий пример — пограничный, а не типичный. Классы без единого примера модель почти всегда занижает.
Примеры влияют на стоимость запроса?
Да, и на каждом запросе. Примеры уходят в модель вместе с промптом как входные токены. Пятнадцать примеров по 150 токенов — это 2250 токенов сверху в каждом обращении. При постоянном префиксе часть этой суммы снимает кэш промптов.
Когда примеры пора выносить из промта в поиск по базе?
Когда их становится больше пятнадцати-двадцати, когда они устаревают быстрее, чем вы правите промпт, или когда нужные примеры зависят от конкретного запроса. Тогда примеры хранят отдельно и подставляют в промпт три-пять подходящих под текущий вход.
Почему модель отвечает однотипно, хотя примеры разные?
Скорее всего, они разные только по содержанию, но одинаковые по форме: та же длина, та же структура, тот же тип случая. Модель копирует форму охотнее, чем смысл. Лечится тем, что в набор добавляют короткий, длинный и пограничный случай.